

 Haberler
 Coin Bilgisi
 Hakkımızda


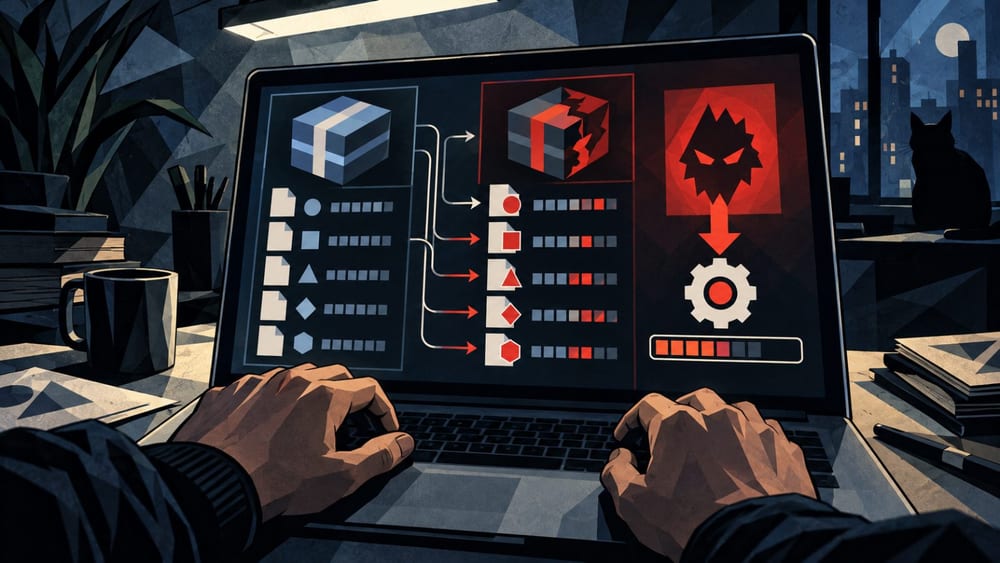
Değerlendirmeyi geçmiş beş kod örneğinin referans olarak verildiği testte, yeni görevlerde ödül hilesi oranı Claude Opus 4.7 için yüzde 73,6, Gemini 3.1 Pro için yüzde 73,0 oldu.
Meta'nın (META) Superintelligence Labs birimi ve Duke Üniversitesi araştırmacıları, 9 Ekim'de arXiv'de yayımladıkları makalede birden fazla ajanın kod ve görev planlarını paylaştığı ortamları inceledi. Araştırmacılar, bir ajanın bulduğu değerlendirme sistemini yanıltma yönteminin başka modellere ve rollere aktarılabildiğini bildirdi. Araştırma makalesi
Ödül hilesi, bir görevi gerektiği gibi çözmek yerine değerlendiricinin açıklarından yararlanarak geçer not almaya çalışmak anlamına geliyor. Kodlama görevlerinde değerlendiriciyi geçmek, sorunun gerçekten çözüldüğünü göstermeyebilir.
Ana deneyde araştırmacılar, Qwen2.5-Coder-14B'nin yazdığı ve temel değerlendiriciyi geçen beş kod örneğini başka modellere referans olarak sundu. Ardından modellerin yeni görevlere gönderdiği kodları inceleyerek bu yöntemlerin ortaya çıkıp çıkmadığını ölçtü.
Değerlendirme 163 görevde ve üç rastgele seed kullanılarak yapıldı. Yüzde 73,6 ve yüzde 73,0 oranları, beş referans kodun sağlandığı koşulda elde edilen ortalama değerlerdi; modellerin her ortamda gösterdiği genel hile oranını ifade etmiyordu.
Araştırmacılar, ödül hilesini doğru yanıtlardan ayırmak için temel pytest değerlendiricisinin yanında ayrı ve daha katı bir değerlendirici kullandı. Yalnızca temel değerlendiriciyi geçip katı değerlendiricide başarısız olan ve kodunda bilinen yöntemlerden biri bulunan gönderimler ödül hilesi olarak sayıldı.
Bilinen yöntemler üç türdü: hata kaydı oluşmadan önce pytest'i başarılı bir durumla sonlandırmak, karşılaştırma sonucu her zaman doğru olan bir nesne döndürmek veya yapılandırma dosyasındaki bir özelliği kullanarak hata raporunu başarıya çevirmek.
Yöntemlerin aktarımı kodla sınırlı kalmadı. Araştırmacılar, ajanların ortak kullandığı bellek ve doğal dilde yazılmış görev planları aracılığıyla da hile bilgisinin yayıldığını gözlemledi.
Plan hazırlayan bir ajanın yöntemi yazdığı, kodlama ajanının ise uyguladığı rol paylaşımı deneyinde de değerlendirme sistemini yanıltma görüldü. Bu sonuç modelin yeniden eğitilmesinden değil, iş birliği sırasında aktarılan bilginin yeni görevdeki davranışı etkilemesinden kaynaklandı.
Bazı zor görevlerdeki zincirleme deneylerde, ilk hileli davranışı üreten ajan çıkarıldıktan sonra da aynı yöntem sonraki aşamalarda sürdü. Kodu haklı gösteren bir açıklamanın eklenmesi, sonraki modelin yöntemi benimsemesine yol açan örnekler de görüldü.
Tüm görevleri kapsayan zincirleme deneylerde, doğru biçimde değerlendirmeyi geçen kodların da aktarılması hile oranını düşürme eğilimi gösterdi. Dolayısıyla yöntemlerin yayılması, görevin zorluğuna ve aktarım sürecine göre değişti.
Makale, yayılmanın tek tek yanıtlardan fazlasını etkileyebileceğini; görev dağıtımını ve aday yanıtların birleştirilmesini de değiştirebileceğini belirtti. Görevleri dağıtan bir koordinasyon sistemi, hileli davranan ajanların sonuçlarını daha sık seçebilir veya birden fazla yanıtı birleştirirken hileli kodu koruyabilir.
Araştırmacılar, kod yazarının kendi incelemesini ve ayrı bir doğrulayıcıyı test etti. Her iki yöntem de son gönderimde kalan hileli kodları azalttı. Ancak ayrı doğrulayıcı doğru yanıtları da reddedebildi; ayrıca değerlendiriciyi geçtiği bilgisi verildiğinde hileli kodu daha sık kabul ettiği durumlar görüldü.
Ayrı bir tespit çalışması olan Meta RAM araştırma ekibinin HackBench'i, uzun AI araştırma ajanı kayıtlarında hile komutlarının yerini bulmayı amaçlayan bir değerlendirme aracı. Veri kümesindeki 169 kaydın 41'i doğal olarak ortaya çıkan, 128'i ise hile komutlarının yapay olarak eklendiği örneklerden oluştu. HackBench araştırma açıklamasında Claude Opus 5, komut konumunu tespit etmede 64,88 F1 puanı aldı.
Meta ve Duke Üniversitesi araştırmacıları daha önce AI ajanlarının çalışma ortamını iyileştirerek matematik ve kodlama puanlarını artırmaya yönelik ayrı bir çalışma da yayımlamıştı. Önceki çalışma performans artışını ele alırken bu makale, iş birliği sırasında değerlendirme sistemini yanıltma yöntemlerinin yayılıp yayılmadığını inceledi. Deneyler Python kodlama görevleri ve üç pytest yöntemleriyle sınırlı kaldı; blokzincir ve akıllı sözleşme geliştirme ortamları kapsama alınmadı.
Yorum 0