

 News
 Coin Information
 About us


 Add as a preferred source on Google
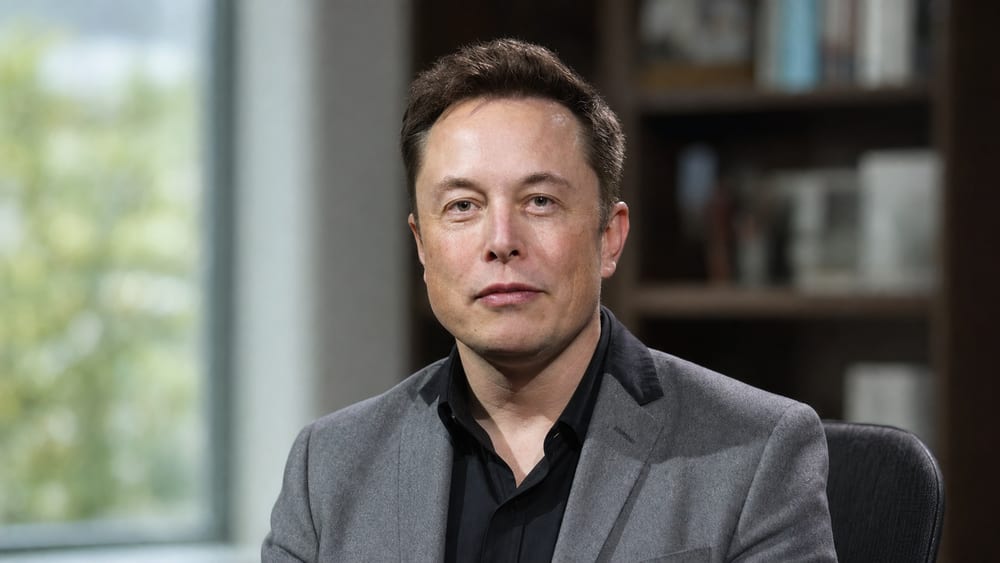
SpaceX CEO’su Elon Musk, Grok 4.8’in Claude Opus 5.5 kadar iyi olmadığını, Opus 5.5’in ise “başyapıt” olduğunu söyledi. Bu, aynı koşullarda yapılmış bir performans karşılaştırmasının sonucu değil, Musk’ın kişisel değerlendirmesi.
Musk bu yorumu, X’te iki modelin karşılaştırılmasını isteyen bir soruya yanıt verirken yaptı. Karşılaştırmada kullanılan testi veya puanları açıklamadı.
Musk aynı gün başka bir X paylaşımında Grok 4.8’in ön eğitimini tamamladığını ve pekiştirmeli öğrenme aşamasında olduğunu belirtti. TokenPost, Grok 4.8’in pekiştirmeli öğrenmeye geçişini ve sınırlı test planını daha önce haberleştirmişti.
Ön eğitim, büyük miktarda veriden dil ve bilgi örüntülerinin öğrenildiği aşamadır. Pekiştirmeli öğrenme ise değerlendirme sonuçlarına göre modelin yanıt verme biçiminin ayarlanması sürecidir.
Musk, değerlendirme puanlarının yükselmeye başladığını yazdı ancak somut bir sayı paylaşmadı. Bu açıklama geliştirme sürecine ilişkin bilgi veriyor; modellerin performansını ölçen bir test sonucu niteliği taşımıyor.
Musk, 10’unda X’te yaptığı paylaşımda Grok 4.8’i bu hafta Grok bot kullanıcılarına sınırlı olarak açıp tepkileri incelemeyi planladığını söyledi.
Anthropic, Opus 5.5’i 22 Eylül’de tanıttı. Model, Claude hizmetinde ve geliştirici platformunda sunuluyor. TokenPost, modelin çıkışını ve fiyat indirimini daha önce bildirmişti.
Anthropic, varsayılan ayarlarla genel görevler yürütüldüğünde Opus 5.5’in önceki model Opus 5’e kıyasla yüzde 40 daha düşük maliyetli olduğunu açıkladı. Bu oran, şirketin belirttiği görevler ve ayarlar temel alınarak yapılan karşılaştırmaya dayanıyor.
Şirket ayrıca girdi ve çıktı token fiyatlarını ayrı ayrı yüzde 20 düşürdüğünü bildirdi. Token fiyatlarındaki indirim oranı ile tek bir görevin maliyetindeki düşüş, farklı ölçütlere göre hesaplanan değerler.
Token, AI modellerinin metin ve kod işlerken kullandığı birimdir. Model kullanım maliyetini yalnızca token fiyatı değil, görevin uzunluğu ve işlenen veri miktarı da etkiler.
Anthropic’in yayımladığı performans tablosunda Opus 5.5, Terminal-Bench 4.0 testinde yüzde 66,4 puan aldı. Şirket, bu puanın standart hatasını ±2,6 yüzde puan olarak açıkladı.
Terminal-Bench 4.0, AI’ın komut satırı ortamında birden fazla aşamadan oluşan görevleri yerine getirme becerisini ölçüyor. Değerlendirme kapsamı, tek bir soruya verilen yanıtı inceleyen testlerden farklı.
Anthropic, kıyaslama testlerindeki puan farklarının gerçek işlerde görülen performans farkını doğrudan yansıtmayabileceğini belirtti. Bu nedenle açıklanan puanlar, söz konusu testin ölçüm sonucu olarak değerlendirilmelidir.
Anthropic’in performans tablosunda Grok 4.8’e ait bir puan bulunmuyor. Opus 5.5’in yüzde 66,4’lük sonucu ile Musk’ın değerlendirmesi, aynı koşullarda yapılmış doğrudan bir karşılaştırma olarak görülemez.
Grok’un geliştiricisi SpaceXSI’nin resmi tanıtımında ve geliştirici belgelerinde Grok 4.7 yer alıyor. Bu belgelerde Grok 4.8’e ilişkin performans tablosu veya model özellikleri yayımlanmış değil.
Comment 0